대규모 시스템의 구성에서 반드시 고려해야 할 것
by 이무제 기자 자료제공 : Audinate, Revemma, Avnu Alliance
아날로그 오디오 시스템에서 케이블의 역할은 비교적 명확하다. 한쪽에서 입력된 전기 신호가 반대쪽으로 전달된다. 디지털 오디오에서도 AES3나 MADI와 같은 전통적인 전송 방식을 사용한다면 사고방식은 크게 달라지지 않는다. 케이블의 양쪽 끝에 송신기와 수신기가 있고 그 사이로 일정한 순서에 따라 데이터가 이동한다.
네트워크 오디오는 조금 다르다. 오디오 신호는 작은 데이터 패킷으로 나뉘고, 각각의 패킷은 네트워크 스위치를 거쳐 목적지로 전달된다. 같은 스위치와 케이블에서는 오디오뿐 아니라 클록 정보와 장치 제어 데이터, 경우에 따라 영상이나 일반 IT 데이터까지 함께 이동한다. 수십 채널 규모에서는 이러한 차이가 크게 드러나지 않을 수도 있다. 그러나 FOH 콘솔과 모니터 콘솔, 스테이지박스, 시스템 프로세서, 앰프, 방송 시스템과 멀티트랙 레코더가 하나의 네트워크에서 수백 채널을 공유하기 시작하면 이야기가 달라진다.
이때 흔히 가장 먼저 떠올리는 것이 대역폭이다. 1GbE로 몇 채널까지 보낼 수 있는가, 10GbE가 필요한 시점은 언제인가와 같은 문제다. 그러나 실제 대규모 오디오 네트워크에서 더 본질적인 문제는 단순한 전송량이 아니다. “각 오디오 샘플을 필요한 시점까지 전달하고, 여러 장치가 그것을 동일한 시간축 위에서 재생하도록 만드는 것”이다. 결국 네트워크 오디오 설계의 핵심은 ‘얼마나 빠른가’가 아니라 ‘얼마나 예측 가능한가’에 있다.
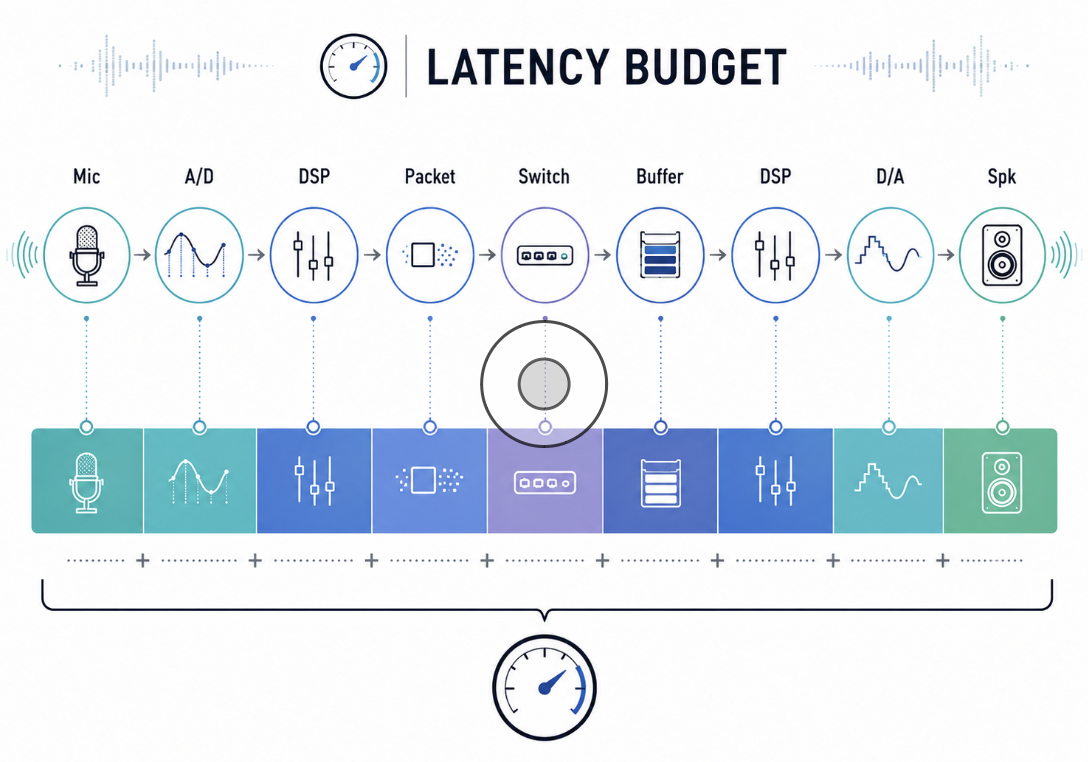
네트워크 오디오의 레이턴시는 단순한 숫자가 아니다
오디오 장비의 사양표에서 레이턴시를 보면 흔히 단순히 눈에 보이는 숫자로 생각하기 쉽다. 하지만 마이크 입력에서 스피커 출력까지 실제로 발생하는 지연은 여러 단계의 합이다.
아날로그 입력은 A/D 변환을 거쳐 디지털 데이터가 되고, DSP에서 처리된 뒤 네트워크 송신부에서 패킷으로 만들어진다. 패킷은 스위치와 케이블을 지나 수신 장치에 도착하고, 수신 버퍼에서 재생 시점을 기다린다. 이후 다시 DSP를 거치거나 D/A 변환되어 아날로그 신호가 된다.
따라서 전체적인 지연은 대략 다음과 같은 요소로 나눌 수 있다.
A/D 변환 → DSP → 패킷화 → 네트워크 전송 → 수신 버퍼 → DSP → D/A 변환
여기서 중요한 것은 Dante Controller 등에 표시되는 ‘1ms’와 같은 값이 이 전체 경로의 레이턴시를 뜻하는 것이 아니라는 점이다. 이는 일반적으로 “네트워크를 통해 패킷을 안정적으로 받아 재생하기 위해 수신기가 확보하는 시간 여유”에 가깝다. 실제 아날로그 입력부터 출력까지의 지연에는 콘솔과 프로세서, 컨버터 등 각 장치의 처리시간이 별도로 추가된다. 이 개념을 음향적으로 표현하면 ‘Latency Budget’, 즉 “레이턴시 예산”이라고 볼 수 있다. 전체 시스템이 허용할 수 있는 지연시간이 있다면 그 안에서 A/D, DSP, 네트워크, D/A 등이 각자의 시간을 나눠 갖는다.
예를 들어 라이브 사운드에서 마이크부터 스피커까지 3ms의 전체 레이턴시를 목표로 한다고 가정하자. 네트워크가 1ms라고 해서 나머지 2ms를 모두 사용할 수 있는 것은 아니다. 콘솔 내부 DSP, 플러그인, FIR 필터, 시스템 프로세서와 앰프의 DSP, 컨버터에서도 각각 시간이 소요된다. 반대로 레코딩 시스템에서는 네트워크 자체의 레이턴시가 조금 더 길더라도 모니터링 경로와 분리되어 있다면 문제가 되지 않을 수도 있다. 따라서 네트워크 오디오의 레이턴시를 논할 때에는 반드시 “네트워크 레이턴시와 시스템 전체의 End-to-End Latency”를 구분해야 한다.
스위치를 많이 거치면 정말 소리가 늦어지는가
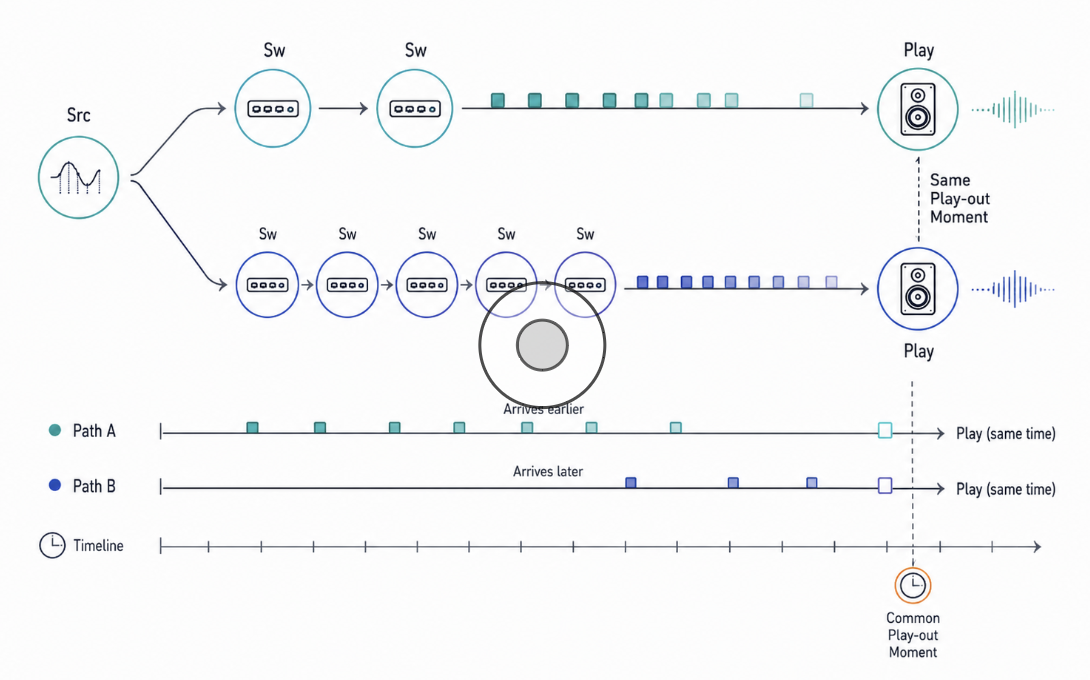
네트워크 스위치를 하나 통과할 때마다 지연이 발생한다는 설명은 틀리지 않는다. Ethernet 네트워크에는 크게 네 종류의 지연 요소가 존재한다. 케이블을 따라 신호가 이동하는 propagation delay, 패킷을 선로에 실어 보내는 serialization delay, 스위치가 목적지를 판단하고 전달하는 forwarding delay, 그리고 다른 패킷이 먼저 지나가기를 기다리는 queueing delay다. 이 가운데 앞의 세 요소는 특정 구성에서는 비교적 일정하지만 queueing delay는 트래픽 상태에 따라 변화한다. 따라서 스위치 홉이 늘어나면 물리적인 전송시간도 분명히 증가한다. 문제는 여기서 곧바로 ‘스위치를 열 개 지나간 스피커가 한 개만 지난 스피커보다 늦게 소리를 낸다’고 결론내리는 데 있다. 현대적인 실시간 네트워크 오디오 시스템은 보통 그렇게 동작하지 않는다.
Dante를 예로 들면 수신 장치는 패킷이 도착하는 즉시 오디오를 출력하는 것이 아니라 정해진 수신 레이턴시를 기준으로 재생한다. Audinate는 일반적인 Dante 장치의 기본 레이턴시인 1ms가 Gigabit 코어에서 상당한 규모의 네트워크에 적용될 수 있으며, 최대 약 10개의 스위치 홉을 포함하는 구성도 이 범위의 예로 제시한다. 작은 Gigabit 전용 네트워크에서는 일부 장치가 훨씬 낮은 값도 사용할 수 있다.
예를 들어 두 개의 네트워크 출력 장치를 생각해보자. A 장치까지 패킷이 150µs 만에 도착하고 B 장치에는 여러 스위치를 거쳐 350µs 만에 도착했다고 가정한다. 수신 레이턴시가 1ms라면 두 패킷 모두 재생 예정 시각보다 충분히 일찍 도착한 것이다. A가 150µs에 패킷을 받았다고 곧바로 출력하는 것이 아니라 B와 마찬가지로 공통 시간축의 정해진 순간까지 기다린다. 즉 “전송시간이 동일한 것이 아니라 재생시간을 동일하게 만드는 구조”다. Audinate는 실제로 Dante의 receiver latency가 네트워크의 지연 변화를 흡수하기 위한 값이며, 이를 통해 재생 시점을 일정하게 유지한다고 설명한다.
따라서 네트워크 오디오에서 스위치 홉의 증가는 중요하지만 그 이유를 단순한 누적 딜레이로만 이해해서는 안 된다. “홉이 많아질수록 패킷이 지나야 할 구간이 많아지고, 혼잡이나 잘못된 설정에 노출될 가능성이 증가하며, 필요한 latency margin이 커질 수 있다는 것”이 보다 정확한 설명이다.
네트워크 오디오의 핵심은 패킷보다 ‘시계’다
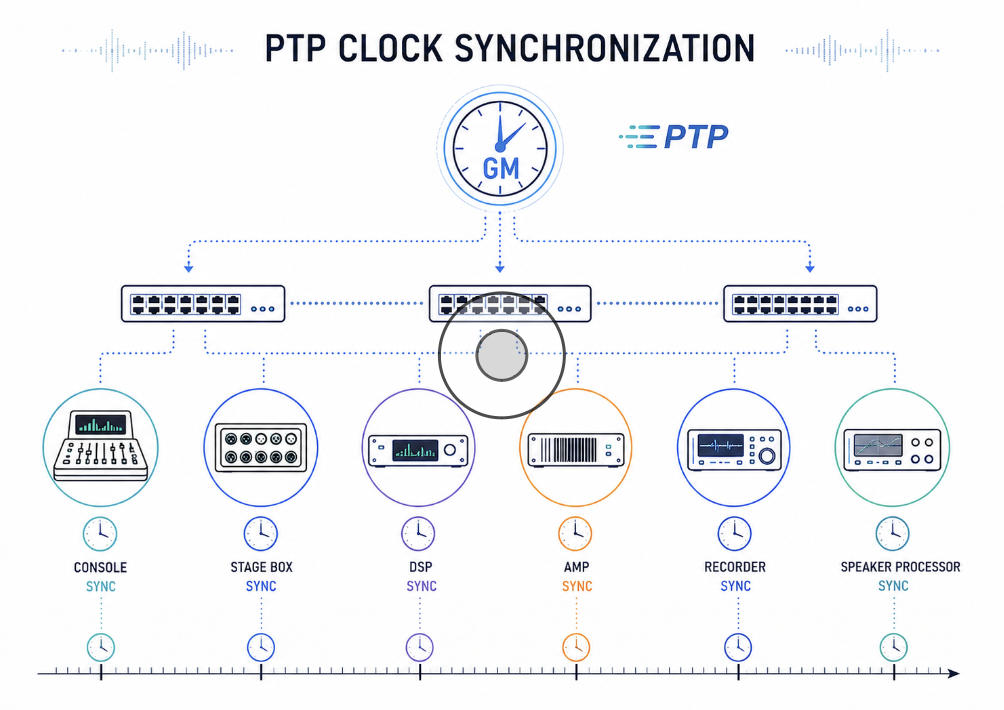
서로 다른 장치가 동일한 순간에 오디오를 재생하려면 모두가 같은 시간을 알고 있어야 한다. 전통적인 디지털 오디오 시스템에서는 Word Clock이 이 역할을 맡았다. 48kHz 시스템이라면 모든 장치가 초당 48,000개의 샘플을 같은 속도로 처리하도록 기준 클록을 공급한다.
네트워크에서는 케이블 하나가 단순한 클록 케이블 역할만 수행하지 않는다. 오디오 데이터와 제어 데이터가 함께 이동하고 장치와 장치 사이의 전송시간도 일정하지 않다. 따라서 네트워크에 연결된 장치들은 단순히 같은 주파수를 공유하는 것에 그치지 않고 “현재 네트워크 시간이 어디에 있는지”까지 알아야 한다. 이 역할을 하는 것이 PTP, Precision Time Protocol이다.
PTP 시스템에서는 기준 역할을 하는 리더 또는 Grandmaster와 이를 따르는 Follower들이 존재한다. 네트워크를 통해 시간 정보를 주고받으면서 각 장치의 내부 클록을 공통 시간축에 맞춘다. Dante 역시 IEEE 1588 PTP를 이용해 네트워크 장치를 동기화하며 이를 통해 네트워크 전체에서 sample-accurate한 시간 정렬을 제공한다.
이 개념은 네트워크 오디오를 이해하는 데 매우 중요하다. 패킷의 도착시간과 오디오의 재생시간은 같은 개념이 아니다. 패킷은 조금 빨리 도착할 수도 있고 조금 늦게 도착할 수도 있다. 중요한 것은 재생하기로 약속한 시점 전에 패킷이 도착해 있는가다.
이를 공연에 비유하면 각 연주자가 공연장에 도착하는 시간이 조금씩 다른 것과 비슷하다. 오후 6시 30분에 온 연주자와 6시 50분에 온 연주자가 있다고 해서 공연을 각각 도착 즉시 시작하는 것은 아니다. 모두 오후 7시라는 동일한 시작시간을 기준으로 연주한다. PTP가 ‘오후 7시가 언제인가’를 정의한다면 receiver buffer는 그 시간까지 연주자가 기다리는 대기실에 해당한다.
버퍼는 레이턴시를 만드는 악역이 아니다
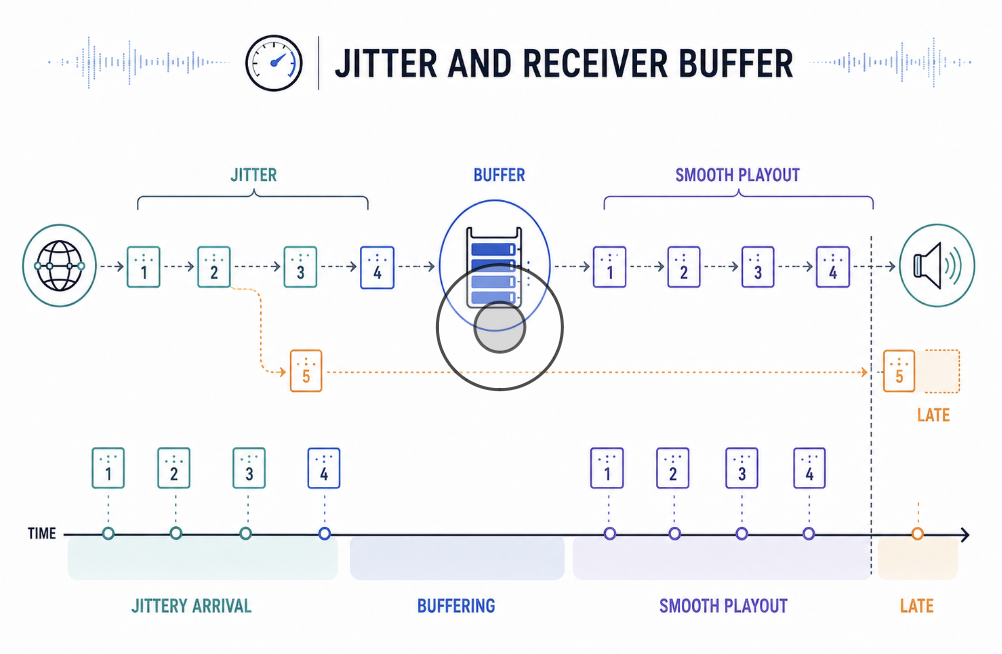
디지털 오디오에서는 흔히 버퍼가 작을수록 좋은 것으로 생각한다. DAW에서 ASIO Buffer를 64 samples로 내리면 512 samples보다 모니터링 레이턴시가 줄어드는 것이 대표적인 사례다. 그러나 네트워크 오디오에서 버퍼는 단순히 제거해야 하는 지연이 아니다. “불규칙한 네트워크에서 일정한 오디오 출력을 보장하기 위한 안전장치”다.
수신 레이턴시를 1ms로 설정했다면 패킷은 그 시간 안에 도착해야 한다. 100µs 만에 도착하든 600µs 만에 도착하든 정상적으로 재생할 수 있다. 그러나 패킷이 정해진 재생 시각을 지나 1.1ms 뒤에 도착했다면 상황이 달라진다. 실시간 오디오 시스템은 파일 다운로드처럼 늦게 도착한 패킷을 무한정 기다릴 수 없다. 이미 재생할 시간이 지나갔기 때문이다. Dante Controller에서도 패킷이 설정된 latency에 근접하거나 이를 넘어 도착하면 latency error로 표시하며, 설정값을 넘어선 경우 실제 오디오 glitch가 발생할 수 있다고 명시한다. 따라서 낮은 레이턴시는 항상 좋은 것이 아니다.
네트워크의 최악 조건에서도 패킷이 400µs 안에 들어오는 시스템에서 1ms 버퍼를 사용하는 것은 충분히 안정적이다. 같은 시스템에서 250µs로 줄이면 평상시에는 잘 작동하더라도 순간적인 congestion이 발생했을 때 drop-out 가능성이 커진다. 이것이 네트워크 오디오에서 “‘최저 레이턴시’보다 ‘안정적으로 보장 가능한 레이턴시’가 중요한 이유”다.
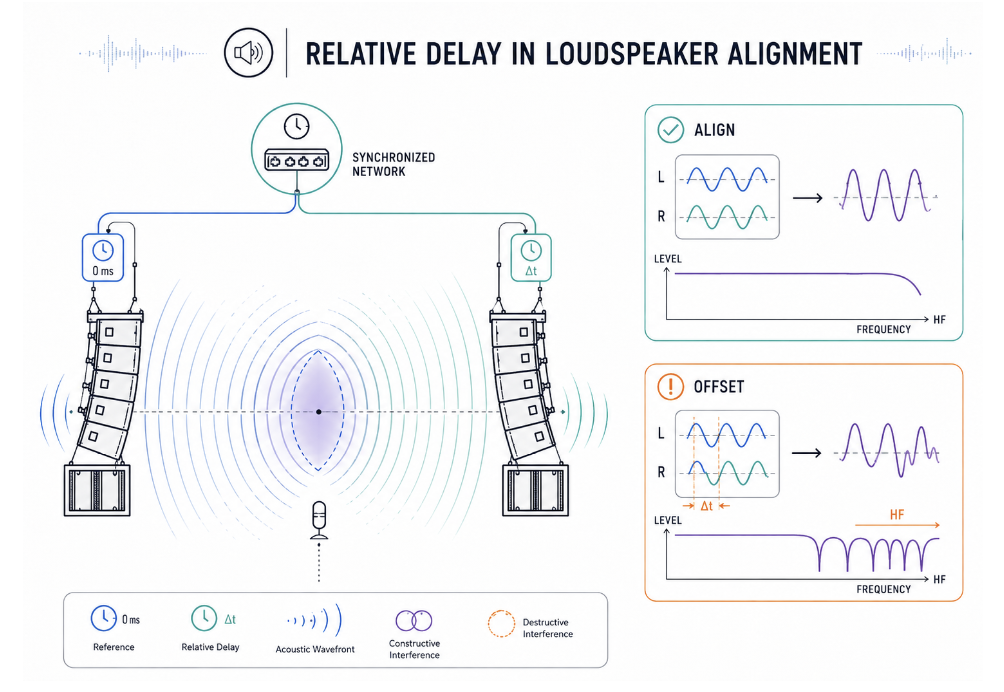
라인어레이에서 수십 µs는 정말 문제가 되는가
여기서 프로 오디오 엔지니어에게 익숙한 시간 단위로 돌아갈 필요가 있다. 48kHz 시스템에서 한 샘플의 길이는 약 20.8µs다. 100µs는 약 4.8 samples에 해당한다. 음속을 약 343m/s로 보면 100µs 동안 음파가 이동하는 거리는 약 3.4cm다. 반대로 1ms는 약 34cm에 해당한다. 그래서 라인어레이 또는 여러 스피커가 중첩되는 시스템에서 100µs의 “상대적인” 시간 오차는 무시하기 어렵다. 동일한 신호를 같은 레벨로 재생하는 두 소스 사이에 정확히 100µs의 시간차가 존재한다고 가정하면 첫 번째 완전 상쇄 지점은 약 5kHz에 나타난다. 10kHz에서는 다시 한 주기 차이가 되며 이후에도 comb filtering이 반복된다. 즉 수십~수백 µs는 고역의 합성에서는 충분히 의미 있는 시간이다.
하지만 여기서 한 가지 중요한 구분이 필요하다. “네트워크 전체의 절대 레이턴시가 1ms라는 사실과 두 스피커의 출력이 1ms 어긋나 있다”는 것은 전혀 다른 이야기다. 두 앰프가 각각 1ms의 동일한 네트워크 receiver latency를 사용하고 같은 PTP 시간축에 맞춰 재생한다면 네트워크 패킷의 실제 이동시간이 조금 달라도 두 출력은 정렬될 수 있다.
반대로 네트워크 구간은 정확하게 동기화되어 있더라도 이후의 DSP 경로가 다르면 실제 아날로그 출력은 어긋날 수 있다. 한쪽에는 FIR 필터가 있고 다른 쪽에는 없거나, 서로 다른 제조사의 DSP와 컨버터를 사용하거나, Sample Rate Converter와 look-ahead limiter가 추가되어 있다면 각 장치의 처리시간이 달라진다. 따라서 라인어레이나 Main/Fill, Main/Sub 시스템에서 네트워크 동기화가 정확하다는 이유만으로 실제 음향 출력까지 자동으로 정렬되었다고 판단해서는 안 된다.
네트워크는 “패킷을 공통 시간에 전달하는 문제”를 해결한다. 최종적인 음향 정렬은 여전히 시스템 프로세서와 측정 시스템을 이용해 확인해야 한다. 오히려 여기서 중요한 것은 ‘네트워크가 몇 µs 늦느냐’보다 “서로 다른 신호 경로 사이에 얼마만큼의 상대 지연이 존재하는가”다.
실제 현장에서는 음향 전파시간이 네트워크보다 훨씬 크다
대규모 공연장을 생각하면 이 관계가 더욱 분명해진다. 공기 중에서 소리는 약 1m 이동하는 데 2.9ms 정도가 걸린다. 메인 PA에서 30m 떨어진 딜레이 스피커까지의 음향 전달시간은 약 87ms에 달한다. 이에 비하면 몇 개의 Ethernet 스위치를 통과하며 발생하는 수십~수백 µs의 네트워크 차이는 매우 작다. 그렇다고 네트워크의 시간 정확도가 중요하지 않다는 뜻은 아니다. 오히려 반대다.
스피커 사이의 거리에 따라 발생하는 87ms의 차이는 “알려진 값이며 의도적으로 보정할 수 있는 지연”이다. 반면 네트워크 congestion 때문에 어느 순간 200µs였다가 다음 순간 800µs가 되는 지연은 예측하기 어렵다. 음향 시스템에서는 크기보다 “변동성”이 더 위험한 경우가 많다. 87ms의 고정된 딜레이는 DSP에서 정확하게 보정할 수 있다. 그러나 매 순간 값이 달라지는 지터는 단순한 delay parameter로 해결할 수 없다.
따라서 네트워크 오디오의 목표는 ‘0에 가까운 지연’이 아니라 “경계를 알고 있는 지연, 즉 bounded latency를 확보하는 것”이다.
이 개념은 Milan/AVB 계열에서 특히 명확하게 나타난다. Milan은 gPTP와 Stream Reservation 등의 기능을 이용해 필요한 네트워크 자원과 시간 특성을 관리하고, 예측 가능한 bounded latency를 네트워크 설계의 핵심 요소로 삼는다.
수백 채널 네트워크에서는 채널 수보다 ‘어디로 보내는가’가 중요하다
대규모 네트워크 오디오에서는 자연스럽게 대역폭 문제가 등장한다. 48kHz/24bit PCM 한 채널의 순수 오디오 데이터만 계산하면 약 1.152Mbps다. 여기에 Ethernet과 IP, UDP 등의 헤더가 추가되므로 실제 네트워크 사용량은 더 커진다.
Dante에서는 일반적인 48kHz/24bit 환경을 기준으로 unicast audio flow 하나가 최대 4채널을 포함하며 약 6Mbps의 대역폭을 사용하는 것을 실무적인 계산 기준으로 제시한다. Multicast의 경우 채널당 약 1.5Mbps 정도를 기준으로 계산할 수 있다. 따라서 단순 계산하면 64채널은 약 96Mbps, 256채널은 약 384Mbps, 512채널은 약 768Mbps 수준이다.
이 숫자만 보면 1GbE에서도 상당히 많은 채널을 운반할 수 있는 것처럼 보인다. 그러나 실제 시스템에서는 같은 256채널이 여러 목적지로 이동한다. 예를 들어 대형 콘서트에서 Stage I/O의 입력 신호를 FOH Console, Monitor Console, Broadcast Console과 Recording System이 모두 받아야 한다고 가정해보자. 한 곳으로만 보내는 256채널은 약 384Mbps지만 동일한 데이터를 세 개의 독립적인 목적지로 각각 unicast한다면 공통 구간에서 필요한 트래픽은 조건에 따라 그 배수로 증가할 수 있다. 세 개의 복사본이 하나의 공통 uplink를 통과한다면 단순 합산만으로 약 1.15Gbps가 된다. 이미 1GbE 단일 링크가 감당할 수 있는 범위를 넘어선다.
따라서 네트워크 규모를 평가할 때 ‘몇 채널인가’만 물어서는 부족하다. 보다 중요한 질문은 ‘한 채널을 몇 곳에서 동시에 필요로 하는가’이다. 같은 300채널 시스템이라도 모든 신호가 point-to-point로 이동하는 시스템과 100개의 소스를 각각 20개의 구역에서 사용하는 시스템은 전혀 다른 네트워크다.
Unicast와 Multicast는 ‘1:1’과 ‘공동 배급’의 차이다
Unicast는 하나의 송신자가 하나의 수신자에게 데이터를 보내는 방식이다. FOH 콘솔 한 대만 특정 채널을 필요로 한다면 매우 단순하다. 송신 장치는 FOH를 향해 한 개의 데이터 흐름을 만들면 된다. 그러나 같은 신호를 FOH, Monitor, Broadcast, Recording 네 곳에서 받아야 한다면 동일한 데이터를 네 번 보내야 할 수도 있다.
Multicast는 이를 다르게 처리한다. 송신자는 하나의 multicast stream을 만들고 여러 수신기가 이를 구독한다. 네트워크 스위치가 필요한 지점에서 데이터를 복제하기 때문에 동일한 소스를 다수의 장치에 배포할 때 효율적이다. Audinate 역시 하나의 오디오 채널 또는 채널 그룹을 보통 세 곳 이상에서 받을 경우 multicast가 대역폭을 효율적으로 사용할 수 있는 방법이라고 설명한다.
그러나 multicast가 항상 unicast보다 좋은 것은 아니다. 한 곳에서만 필요한 신호까지 무조건 multicast로 만들면 불필요하게 네트워크 관리가 복잡해질 수 있다. 무엇보다 multicast는 제대로 관리하지 않으면 해당 데이터가 필요하지 않은 포트까지 퍼질 수 있다. 이른바 multicast flooding이다. 바로 여기에서 IGMP가 필요해진다.
IGMP는 거대한 오디오 분배기의 패치 리스트다
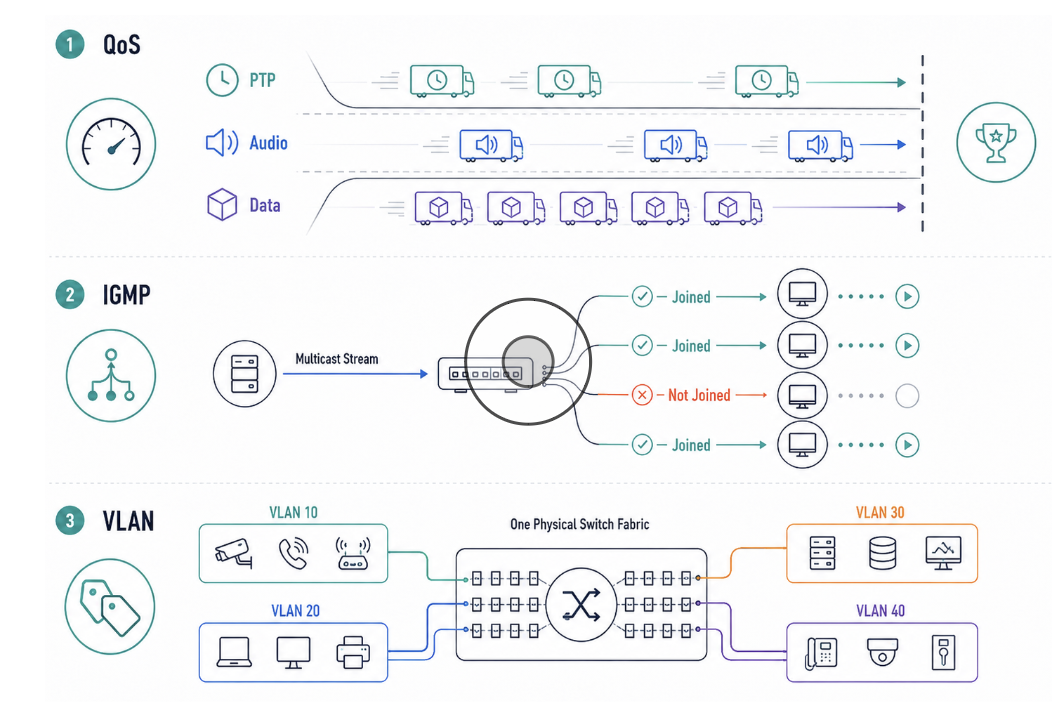
IGMP는 Internet Group Manage-ment Protocol의 약자다. 이 이름만 보면 음향 엔지니어가 접근하기 어려운 IT 기술처럼 느껴지지만 역할은 단순하다. 어떤 포트가 어떤 multicast stream을 원하는지 스위치가 기억하도록 하는 것이다.
예를 들어 64채널의 오디오 스트림이 있고 네트워크에는 50개의 장치가 연결되어 있다고 가정하자. 이 중 실제로 해당 스트림을 필요로 하는 장치가 세 대뿐이라면 나머지 47대에는 데이터를 보낼 필요가 없다. IGMP Snooping이 활성화된 스위치는 어떤 수신기가 어떤 multicast group에 가입했는지를 확인해 필요한 포트에만 패킷을 전달한다.
반대로 multicast를 제대로 관리하지 않으면 스위치는 어느 장치가 데이터를 원하는지 판단하지 못해 모든 방향으로 보내버릴 수 있다. RAVENNA의 AES67 네트워크 가이드 역시 unmanaged multicast가 링크와 endpoint를 불필요하게 포화시킬 수 있기 때문에 IGMP를 이용한 관리가 필요하다고 설명한다.
이때 IGMP Snooping과 함께 등장하는 것이 IGMP Querier다. Snooping이 ‘누가 어떤 채널을 듣고 있는지 관찰하는 기능’이라면 Querier는 주기적으로 ‘아직 이 multicast를 받고 싶은 장치가 있는가’를 묻는 역할을 한다. 음향 시스템으로 표현하면 IGMP는 거대한 디지털 분배 시스템의 자동 패치 리스트에 가깝다. Multicast가 많아질수록 이 관리가 중요해진다.
QoS는 대역폭을 늘리지 않는다
네트워크 오디오 이야기를 하다 보면 QoS, Quality of Service라는 용어도 반드시 등장한다. QoS를 네트워크를 빠르게 만드는 기능으로 이해하기 쉽지만 사실 정확한 이해는 아니다. QoS는 도로를 넓히는 기술이 아니라 어떤 차량을 먼저 통과시킬지 결정하는 기술이다. 예컨대 1GbE 링크에 1.2Gbps의 트래픽을 지속적으로 밀어 넣는다면 QoS를 아무리 정교하게 설정해도 1.2Gbps를 모두 전달할 수는 없다. QoS가 의미를 갖는 것은 이처럼 여러 종류의 패킷이 동시에 몰릴 때다.
일반적인 Ethernet 스위치에서 오디오 패킷과 웹 데이터, 파일 전송 패킷은 본질적으로 같은 Ethernet/IP 데이터다. 따라서 스위치에게 어떤 패킷을 먼저 처리해야 하는지 알려줄 필요가 있다. DSCP와 같은 우선순위 표시를 이용하면 패킷을 서로 다른 queue로 분류할 수 있고, 시간에 민감한 데이터부터 먼저 내보낼 수 있다.
네트워크 오디오에서는 특히 PTP가 중요하다. 오디오 패킷 하나가 조금 늦는 것보다 모든 장치의 기준이 되는 시간정보가 흔들리는 것이 시스템 전체에는 더 위험할 수 있기 때문이다. Audinate의 Dante 네트워크 가이드는 mixed-use network에서 PTP와 오디오 트래픽에 QoS를 적용할 것을 권고하며, time-critical PTP traffic을 높은 우선순위로 처리하도록 지정하고 있다. RAVENNA의 AES67 지침 역시 PTP와 미디어 패킷의 jitter를 최소화하기 위해 우선순위 queue를 사용하는 구조를 설명한다.
따라서 음향 엔지니어의 관점에서는 QoS를 이렇게 이해하는 것이 가장 쉽다. [혼잡한 상황에서도 클록과 오디오가 먼저 지나갈 차선을 확보하는 것].
다만 QoS는 설계 불량을 치료하는 만능 기능이 아니다. 기본적인 링크 용량이 부족하다면 uplink를 10GbE로 올리거나 트래픽 경로 자체를 재구성해야 한다.
Traffic이 많아지면 결국 Latency 문제가 된다
대역폭과 레이턴시는 처음에는 서로 다른 문제처럼 보인다. 그러나 네트워크가 커질수록 두 문제는 하나로 연결된다. 링크 사용량이 낮을 때에는 패킷이 스위치에 도착하자마자 거의 그대로 다음 링크로 전달된다. 하지만 같은 egress port로 여러 데이터가 동시에 몰리면 한 번에 하나씩밖에 보낼 수 없으므로 나머지는 queue에서 기다려야 한다. 이것이 queueing delay다.
그리고 네트워크 부하는 항상 정확히 일정하지 않다. 순간적으로 많은 데이터가 몰릴 수도 있기 때문에 queue에서 기다리는 시간도 변화한다. 결과적으로
Traffic 증가 → Queueing 증가 → Jitter 증가 → 더 큰 Receiver Buffer 필요 → Latency 증가
라는 관계가 만들어진다.
따라서 대규모 네트워크 오디오에서 트래픽 관리는 단순히 ‘끊기지 않도록 대역폭을 확보하는 것’ 이상의 의미를 가진다. 트래픽을 관리하는 것은 결국 “시간을 관리하는 일”이다.
VLAN은 네트워크를 나누지만 대역폭을 만들어내지는 않는다
대규모 엔터프라이즈나 복합시설에서는 VLAN도 자주 사용한다. VLAN은 하나의 물리적인 스위치 인프라 안에서 서로 다른 논리적 네트워크를 만드는 방식이다. 오디오 장치와 사내 업무망을 분리하거나 층별, 공연장별, 기능별로 broadcast domain을 분리하는 데 유용하다. 오디오 시스템의 관점에서는 대형 콘솔의 Layer나 DCA처럼 생각하기보다는 “하나의 거대한 물리적 패치 시스템 안에 독립된 여러 패치베이를 만드는 것”에 가깝다.
그러나 VLAN에도 흔한 오해가 있다. VLAN을 나눈다고 실제 케이블의 전송용량이 늘어나는 것은 아니다. 예를 들어 네 개의 VLAN이 하나의 1GbE trunk를 공유하고 있다면 네 VLAN을 합친 전체 데이터는 결국 그 1Gbps 링크를 통과해야 한다. VLAN은 불필요한 broadcast와 multicast의 범위를 줄이고 관리 경계를 만드는 데 효과적이지만 물리적인 uplink capacity 자체를 증가시키지는 않는다.
따라서 수백 채널의 오디오와 영상, 제어 신호가 코어로 집중되는 시스템에서는 edge가 모두 1GbE라고 해서 core까지 1GbE여도 된다는 결론이 나오지 않는다. 여러 개의 1GbE edge traffic이 한 지점으로 모이는 순간 10GbE 이상의 backbone이 필요한 이유가 여기에 있다.
Daisy Chain의 문제는 레이턴시보다 구조에 있다
네트워크 지원 앰프나 스피커, DSP 가운데는 Ethernet 포트가 두 개 있어 다음 장비로 연결할 수 있는 제품이 있다. 이 구조는 설치가 편리하다는 점에서 많은 현장서 사랑받으며, 실제로 많은 장비 제조사들이 이런 기능을 넣어 제품을 설계 및 출시하고 있다. 첫 번째 장비에서 두 번째, 두 번째에서 세 번째 장비로 이어가면 별도의 스위치를 여러 곳에 설치하지 않아도 된다.
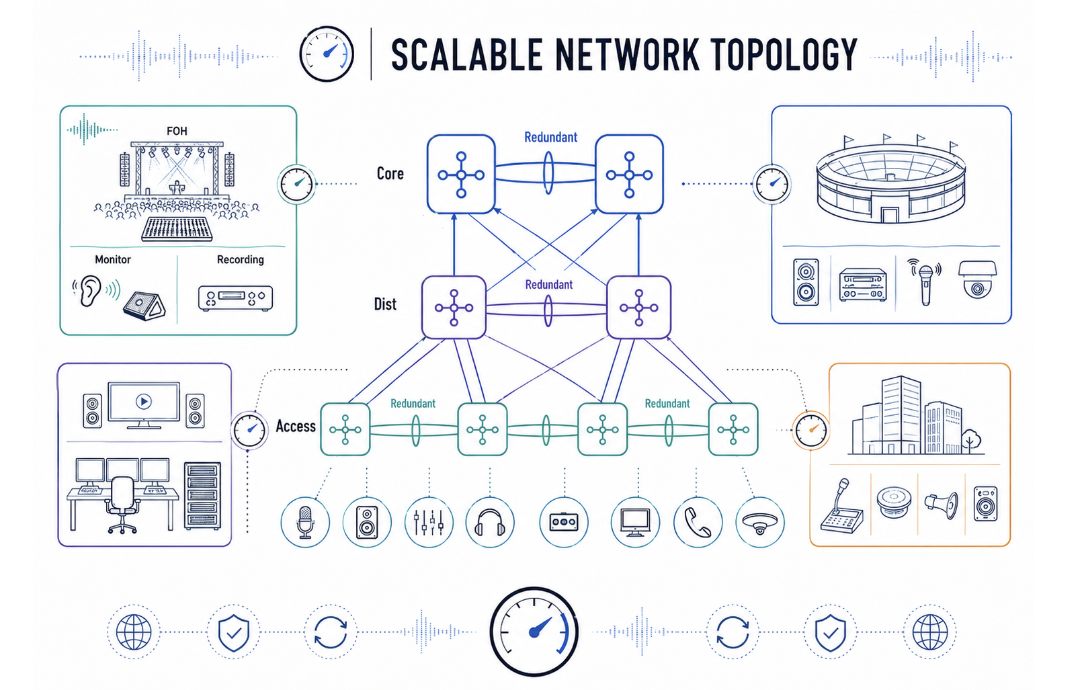
그러나 Daisy Chain을 길게 만들수록 고려할 요소가 늘어난다. 각 endpoint 내부의 네트워크 switch를 추가로 통과하므로 hop이 늘어난다. 중간 장비가 재부팅되거나 전원을 잃었을 때 뒤쪽 연결까지 영향을 받을 수 있는 제품도 있다. 장애 지점을 찾기도 어려워지고, 하나의 링크가 뒤쪽 여러 장치의 traffic을 동시에 부담할 수도 있다.
그렇다고 Daisy Chain을 사용하면 곧바로 라인어레이 정렬이 틀어진다고 볼 수는 없다. 앞서 설명했듯 정상적으로 동기화된 네트워크에서는 각 수신기가 공통 시간축에 맞춰 재생하기 때문이다. 오히려 대형 시스템에서 Daisy Chain을 제한하는 가장 현실적인 이유는 “레이턴시의 단순 누적보다 장애 범위와 트래픽 집중, 토폴로지의 예측 가능성”에 있다. 규모가 커질수록 Access–Distribution–Core처럼 계층화된 구조를 사용하는 이유도 같다. 모든 장비의 경로와 bottleneck을 설계자가 파악하기 쉬워진다.
PTP-aware Switch가 항상 필요한 것은 아니다
PTP 이야기가 나오면 반드시 PTP를 지원하는 고가의 스위치를 사용해야 한다고 생각하기 쉽다. 이 역시 프로토콜과 시스템 규모에 따라 다르다. 일반적인 Dante 네트워크에서 Audinate는 PTP-aware switch를 필수 조건으로 두지 않으며 대부분의 경우 스위치에서 Boundary Clock이나 Transparent Clock 기능을 켤 필요가 없다고 설명한다.
반면 AES67/RAVENNA처럼 PTPv2를 사용하는 대규모 시스템에서는 상황이 달라질 수 있다. 스위치를 매우 많이 통과하거나 네트워크 부하가 높아지면 PTP 메시지 자체가 받는 지터가 증가할 수 있다. 이런 환경에서는 Transparent Clock이 스위치 내부에서 소비된 시간을 보정하거나 Boundary Clock이 PTP 영역을 구분해 각 구간에 보다 안정적인 시간을 제공하는 방식이 유용할 수 있다. RAVENNA 역시 대규모 또는 높은 부하가 걸리는 AES67 환경에서는 Boundary Clock이나 Transparent Clock과 같은 PTP-aware switch를 고려하도록 안내한다. 따라서 ‘PTP 스위치가 좋다’ 또는 ‘필요 없다’는 식의 단순한 결론보다는 “사용하는 AoIP 규격과 네트워크 규모에 따라 요구사항이 달라진다”고 이해해야 한다.
Dante 자체 오디오에서는 기본적으로 PTPv1이 사용되고 AES67 및 ST 2110-30 운용에는 PTPv2가 등장한다. 혼합 네트워크에서는 이 차이까지 고려해야 한다. 최신 Dante 장치에서도 AES67/ST 2110-30을 위한 PTPv2 설정을 별도로 제공한다.
콘서트와 멀티트랙 레코딩을 동시에 한다면
실제 현장에서 흥미로운 사례 중 하나는 대형 콘서트와 멀티트랙 레코딩을 하나의 네트워크에서 처리하는 경우다. 가령 Stage Rack에서 128개의 입력이 발생한다고 가정하자. 이 신호가 FOH Console과 Monitor Console으로 전달되고, 동시에 128채널 DAW에 녹음되며 일부 신호는 Broadcast Console과 시스템 프로세서에서도 사용된다. 이때 모든 목적지가 같은 latency를 가져야 할 이유는 없다.
FOH와 Monitor 등 실제 PA 경로는 가능한 짧고 안정적인 latency가 중요하다. 특히 연주자의 IEM 경로에서는 몇 ms의 차이도 체감될 수 있다. 반면 Recording DAW는 약간 더 긴 network buffer를 사용해도 문제가 없다. 녹음 파일이 공연장의 스피커를 실시간으로 구동하는 것이 아니라면 안정성이 낮은 latency보다 우선한다.
실제로 Dante Virtual Soundcard의 latency 설정은 네트워크의 하드웨어 Dante 장치와 독립적으로 사용할 수 있다. 예를 들어 하드웨어 PA 경로가 1ms로 동작하는 동안 DVS는 더 높은 값을 사용해 레코딩 안정성을 확보할 수 있다. Audinate 역시 고성능 컴퓨터에서는 4ms를 출발점으로 사용하고 시스템 상황에 따라 6ms나 10ms와 같이 더 큰 값을 사용할 수 있다고 안내한다.
이것은 매우 중요한 설계 원칙이다. [네트워크 전체를 하나의 latency 값으로 맞춰야 하는 것이 아니다]. 실시간 PA 경로와 레코딩 경로의 요구조건은 다르다. 각각의 목적에 적절한 latency budget을 설정하는 것이 더 합리적이다.
포스트프로덕션에서는 컴퓨터가 가장 느린 endpoint가 될 수도 있다
포스트프로덕션 스튜디오에서도 비슷한 문제가 발생한다. 수백 채널의 오디오를 여러 편집실과 dubbing stage, machine room 사이에서 공유할 수 있다는 것은 네트워크 오디오의 매우 큰 장점이다. 하지만 전용 하드웨어 DSP와 일반 컴퓨터는 시간 특성이 다르다.
전용 네트워크 오디오 하드웨어는 Ethernet packet 처리와 clock synchronization을 위해 설계된 반면 PC와 Mac은 오디오만 처리하는 장비가 아니다. 운영체제와 드라이버, CPU scheduling, DAW buffer, 플러그인이 모두 추가적인 변수가 된다. 따라서 네트워크 자체가 1ms 이하로 동작한다고 해서 DAW 입출력까지 1ms가 되는 것은 아니다.
특히 Native Plugin, Look-ahead Processing, Linear Phase EQ, FIR Convolution 등을 사용하면 네트워크보다 플러그인 처리시간이 훨씬 큰 경우도 흔하다. 이 때문에 대형 포스트 시스템에서는 ‘네트워크가 느리다’고 판단하기 전에 latency가 실제로 어느 구간에서 발생하는지 나누어 측정해야 한다. Network Latency와 Computer Audio Buffer, Plugin Delay Compensation을 하나의 숫자로 섞어버리면 문제를 찾기 어려워진다.
스타디움과 쇼핑몰에서는 낮은 레이턴시보다 안정성이 더 중요하다
스타디움이나 쇼핑컴플렉스, 공항, 캠퍼스와 같은 대규모 분산 음향 시스템은 공연장과 요구조건이 다르다. 하나의 소스를 수십 또는 수백 개의 구역으로 보내는 일이 많기 때문에 multicast의 효율성이 크게 드러난다. 반대로 multicast 관리가 잘못되면 매우 많은 트래픽이 필요하지 않은 구역까지 퍼질 수 있으므로 IGMP 설계의 중요성도 커진다.
먼저 생각할 것은 이들 시스템에서는 250µs와 1ms의 차이가 사용자 경험에 큰 영향을 주지 않는 경우가 많다. 대신 장시간 끊김 없이 동작해야 하고 네트워크 일부에 장애가 발생하더라도 전체 방송 시스템이 멈추어서는 안 된다. 긴 광케이블 구간과 여러 건물, 여러 VLAN을 통과하더라도 clock synchronization과 traffic path가 예측 가능해야 한다. 즉 대규모 Installed Sound에서 네트워크의 목표는 Ultra-Low Latency보다는 [Deterministic, Scalable, Redundant]이 우선한다.
네트워크의 상태는 귀보다 먼저 숫자로 확인해야 한다
아날로그 시스템의 이상은 대개 귀로 먼저 발견할 수 있었다. 험이 들리거나 레벨이 떨어지고 왜곡이 발생한다. 네트워크는 다르다. 평상시에는 아무 문제가 없다가 특정 시간에만 glitch가 발생할 수 있다. 네트워크 사용량이 순간적으로 증가하거나 PTP 상태가 흔들리거나 특정 uplink에서 latency가 receiver buffer의 경계에 접근할 수 있기 때문이다. 따라서 대규모 AoIP 시스템에서는 단순히 ‘소리가 정상적으로 나온다’는 것만으로 상태를 판단해서는 안 된다.
Transmit/Receive Bandwidth, Packet Error, Clock Status, Latency Histogram과 같은 정보를 지속적으로 확인해야 한다. Dante Controller 역시 장치별 transmit/receive bandwidth, latency statistics, clock stability와 packet error 등을 확인할 수 있도록 제공한다. 특히 정상적인 시스템의 값을 미리 기록해두는 것이 중요하다.
평소 특정 endpoint의 packet latency가 180~220µs 범위인데 어느 날 700µs까지 증가했다면 아직 음이 끊기지 않았더라도 네트워크 어딘가에 변화가 생겼다는 의미다. 프로 오디오에서 헤드룸을 0dBFS에 닿기 전에 관리하듯 네트워크에서도 dropout이 발생하기 전에 “latency와 bandwidth의 headroom을 관리해야 한다.”
결국 관리해야 할 것은 ‘시간의 불확실성’
네트워크 오디오를 처음 접하면 레이턴시를 하나의 숫자로 생각하기 쉽다. 0.25ms가 1ms보다 좋고 1ms가 5ms보다 좋다고 생각한다. 하지만 실제 대규모 시스템에서는 반드시 그렇지 않다.
항상 2ms의 지연을 가지는 시스템과 평상시에는 0.2ms지만 상황에 따라 0.2~3ms 사이에서 변하는 시스템이 있다면 프로 오디오에서는 전자가 더 유용할 수 있다. 2ms라는 값을 알고 있다면 DSP에서 보상할 수 있기 때문이다. 반면 매 순간 달라지는 값은 정확하게 보상할 수 없다.
따라서 네트워크 오디오에서 관리해야 할 진짜 대상은 레이턴시 자체가 아니라 “레이턴시의 불확실성”이다. 이를 위해 PTP로 공통 시간축을 만들고, receiver buffer로 network jitter를 흡수하며, QoS로 시간에 민감한 패킷을 우선 처리한다. Multicast가 필요하다면 IGMP로 이동 범위를 제어하고, VLAN으로 트래픽 영역을 나누며, 충분한 backbone bandwidth를 확보한다. 그리고 이 모든 장치는 결국 하나의 목적을 가진다. “오디오 샘플을 정확한 시간까지 목적지에 가져다 놓는 것.”
네트워크 오디오는 결국 ‘시간을 전송하는 기술’
네트워크 오디오가 전통적인 오디오 배선과 가장 크게 다른 지점은 여기에 있다. 아날로그 시스템에서는 케이블을 따라 신호가 흐른다. 네트워크에서는 패킷이 이동한다. 그러나 프로 오디오에서 필요한 것은 단순한 데이터가 아니다. 왼쪽 라인어레이와 오른쪽 라인어레이, 메인 PA와 프런트필, 무대의 I/O와 FOH 콘솔, 방송실과 레코딩 시스템이 모두 ‘이 샘플이 언제 재생되어야 하는가’를 공유해야 한다.
따라서 대규모 네트워크 오디오를 설계할 때 가장 먼저 물어야 할 질문은 ‘몇 채널까지 들어가는가’가 아니다. 어떤 신호가 어디로 이동하는가, 몇 개의 장치가 같은 신호를 필요로 하는가, 가장 혼잡한 링크는 어디인가, 어떤 경로에 가장 낮은 레이턴시가 필요한가, 어떤 경로는 안정성을 위해 더 큰 버퍼를 허용할 수 있는가, 클록은 어떤 경로를 지나며 장애가 발생했을 때 무엇이 기준이 되는가가 가장 중요하다. 이 질문에 답할 수 있어야 네트워크의 규모가 커져도 시스템의 시간축을 통제할 수 있다.
스위치를 하나 더 거치면 몇 µs가 증가하는지를 아는 것도 필요하다. 그러나 그것만으로 대규모 AoIP 시스템을 이해할 수는 없다. 네트워크 오디오에서 가장 중요한 것은 가장 낮은 레이턴시가 아니다. 오히려 “필요한 모든 신호가, 필요한 모든 장소에서, 약속된 시간에 재생된다는 사실을 보장하는 것”이다. 결국 프로 오디오 네트워크 설계란 수백 개의 오디오 채널을 Ethernet 케이블에 집어넣는 기술이 아니다. “수백 개의 오디오 채널이 공유하는 하나의 시간을 설계하는 기술이다.


대규모 시스템의 구성에서 반드시 고려해야 할 것
by 이무제 기자 자료제공 : Audinate, Revemma, Avnu Alliance
아날로그 오디오 시스템에서 케이블의 역할은 비교적 명확하다. 한쪽에서 입력된 전기 신호가 반대쪽으로 전달된다. 디지털 오디오에서도 AES3나 MADI와 같은 전통적인 전송 방식을 사용한다면 사고방식은 크게 달라지지 않는다. 케이블의 양쪽 끝에 송신기와 수신기가 있고 그 사이로 일정한 순서에 따라 데이터가 이동한다.
네트워크 오디오는 조금 다르다. 오디오 신호는 작은 데이터 패킷으로 나뉘고, 각각의 패킷은 네트워크 스위치를 거쳐 목적지로 전달된다. 같은 스위치와 케이블에서는 오디오뿐 아니라 클록 정보와 장치 제어 데이터, 경우에 따라 영상이나 일반 IT 데이터까지 함께 이동한다. 수십 채널 규모에서는 이러한 차이가 크게 드러나지 않을 수도 있다. 그러나 FOH 콘솔과 모니터 콘솔, 스테이지박스, 시스템 프로세서, 앰프, 방송 시스템과 멀티트랙 레코더가 하나의 네트워크에서 수백 채널을 공유하기 시작하면 이야기가 달라진다.
이때 흔히 가장 먼저 떠올리는 것이 대역폭이다. 1GbE로 몇 채널까지 보낼 수 있는가, 10GbE가 필요한 시점은 언제인가와 같은 문제다. 그러나 실제 대규모 오디오 네트워크에서 더 본질적인 문제는 단순한 전송량이 아니다. “각 오디오 샘플을 필요한 시점까지 전달하고, 여러 장치가 그것을 동일한 시간축 위에서 재생하도록 만드는 것”이다. 결국 네트워크 오디오 설계의 핵심은 ‘얼마나 빠른가’가 아니라 ‘얼마나 예측 가능한가’에 있다.
네트워크 오디오의 레이턴시는 단순한 숫자가 아니다
오디오 장비의 사양표에서 레이턴시를 보면 흔히 단순히 눈에 보이는 숫자로 생각하기 쉽다. 하지만 마이크 입력에서 스피커 출력까지 실제로 발생하는 지연은 여러 단계의 합이다.
아날로그 입력은 A/D 변환을 거쳐 디지털 데이터가 되고, DSP에서 처리된 뒤 네트워크 송신부에서 패킷으로 만들어진다. 패킷은 스위치와 케이블을 지나 수신 장치에 도착하고, 수신 버퍼에서 재생 시점을 기다린다. 이후 다시 DSP를 거치거나 D/A 변환되어 아날로그 신호가 된다.
따라서 전체적인 지연은 대략 다음과 같은 요소로 나눌 수 있다.
A/D 변환 → DSP → 패킷화 → 네트워크 전송 → 수신 버퍼 → DSP → D/A 변환
여기서 중요한 것은 Dante Controller 등에 표시되는 ‘1ms’와 같은 값이 이 전체 경로의 레이턴시를 뜻하는 것이 아니라는 점이다. 이는 일반적으로 “네트워크를 통해 패킷을 안정적으로 받아 재생하기 위해 수신기가 확보하는 시간 여유”에 가깝다. 실제 아날로그 입력부터 출력까지의 지연에는 콘솔과 프로세서, 컨버터 등 각 장치의 처리시간이 별도로 추가된다. 이 개념을 음향적으로 표현하면 ‘Latency Budget’, 즉 “레이턴시 예산”이라고 볼 수 있다. 전체 시스템이 허용할 수 있는 지연시간이 있다면 그 안에서 A/D, DSP, 네트워크, D/A 등이 각자의 시간을 나눠 갖는다.
예를 들어 라이브 사운드에서 마이크부터 스피커까지 3ms의 전체 레이턴시를 목표로 한다고 가정하자. 네트워크가 1ms라고 해서 나머지 2ms를 모두 사용할 수 있는 것은 아니다. 콘솔 내부 DSP, 플러그인, FIR 필터, 시스템 프로세서와 앰프의 DSP, 컨버터에서도 각각 시간이 소요된다. 반대로 레코딩 시스템에서는 네트워크 자체의 레이턴시가 조금 더 길더라도 모니터링 경로와 분리되어 있다면 문제가 되지 않을 수도 있다. 따라서 네트워크 오디오의 레이턴시를 논할 때에는 반드시 “네트워크 레이턴시와 시스템 전체의 End-to-End Latency”를 구분해야 한다.
스위치를 많이 거치면 정말 소리가 늦어지는가
네트워크 스위치를 하나 통과할 때마다 지연이 발생한다는 설명은 틀리지 않는다. Ethernet 네트워크에는 크게 네 종류의 지연 요소가 존재한다. 케이블을 따라 신호가 이동하는 propagation delay, 패킷을 선로에 실어 보내는 serialization delay, 스위치가 목적지를 판단하고 전달하는 forwarding delay, 그리고 다른 패킷이 먼저 지나가기를 기다리는 queueing delay다. 이 가운데 앞의 세 요소는 특정 구성에서는 비교적 일정하지만 queueing delay는 트래픽 상태에 따라 변화한다. 따라서 스위치 홉이 늘어나면 물리적인 전송시간도 분명히 증가한다. 문제는 여기서 곧바로 ‘스위치를 열 개 지나간 스피커가 한 개만 지난 스피커보다 늦게 소리를 낸다’고 결론내리는 데 있다. 현대적인 실시간 네트워크 오디오 시스템은 보통 그렇게 동작하지 않는다.
Dante를 예로 들면 수신 장치는 패킷이 도착하는 즉시 오디오를 출력하는 것이 아니라 정해진 수신 레이턴시를 기준으로 재생한다. Audinate는 일반적인 Dante 장치의 기본 레이턴시인 1ms가 Gigabit 코어에서 상당한 규모의 네트워크에 적용될 수 있으며, 최대 약 10개의 스위치 홉을 포함하는 구성도 이 범위의 예로 제시한다. 작은 Gigabit 전용 네트워크에서는 일부 장치가 훨씬 낮은 값도 사용할 수 있다.
예를 들어 두 개의 네트워크 출력 장치를 생각해보자. A 장치까지 패킷이 150µs 만에 도착하고 B 장치에는 여러 스위치를 거쳐 350µs 만에 도착했다고 가정한다. 수신 레이턴시가 1ms라면 두 패킷 모두 재생 예정 시각보다 충분히 일찍 도착한 것이다. A가 150µs에 패킷을 받았다고 곧바로 출력하는 것이 아니라 B와 마찬가지로 공통 시간축의 정해진 순간까지 기다린다. 즉 “전송시간이 동일한 것이 아니라 재생시간을 동일하게 만드는 구조”다. Audinate는 실제로 Dante의 receiver latency가 네트워크의 지연 변화를 흡수하기 위한 값이며, 이를 통해 재생 시점을 일정하게 유지한다고 설명한다.
따라서 네트워크 오디오에서 스위치 홉의 증가는 중요하지만 그 이유를 단순한 누적 딜레이로만 이해해서는 안 된다. “홉이 많아질수록 패킷이 지나야 할 구간이 많아지고, 혼잡이나 잘못된 설정에 노출될 가능성이 증가하며, 필요한 latency margin이 커질 수 있다는 것”이 보다 정확한 설명이다.
네트워크 오디오의 핵심은 패킷보다 ‘시계’다
서로 다른 장치가 동일한 순간에 오디오를 재생하려면 모두가 같은 시간을 알고 있어야 한다. 전통적인 디지털 오디오 시스템에서는 Word Clock이 이 역할을 맡았다. 48kHz 시스템이라면 모든 장치가 초당 48,000개의 샘플을 같은 속도로 처리하도록 기준 클록을 공급한다.
네트워크에서는 케이블 하나가 단순한 클록 케이블 역할만 수행하지 않는다. 오디오 데이터와 제어 데이터가 함께 이동하고 장치와 장치 사이의 전송시간도 일정하지 않다. 따라서 네트워크에 연결된 장치들은 단순히 같은 주파수를 공유하는 것에 그치지 않고 “현재 네트워크 시간이 어디에 있는지”까지 알아야 한다. 이 역할을 하는 것이 PTP, Precision Time Protocol이다.
PTP 시스템에서는 기준 역할을 하는 리더 또는 Grandmaster와 이를 따르는 Follower들이 존재한다. 네트워크를 통해 시간 정보를 주고받으면서 각 장치의 내부 클록을 공통 시간축에 맞춘다. Dante 역시 IEEE 1588 PTP를 이용해 네트워크 장치를 동기화하며 이를 통해 네트워크 전체에서 sample-accurate한 시간 정렬을 제공한다.
이 개념은 네트워크 오디오를 이해하는 데 매우 중요하다. 패킷의 도착시간과 오디오의 재생시간은 같은 개념이 아니다. 패킷은 조금 빨리 도착할 수도 있고 조금 늦게 도착할 수도 있다. 중요한 것은 재생하기로 약속한 시점 전에 패킷이 도착해 있는가다.
이를 공연에 비유하면 각 연주자가 공연장에 도착하는 시간이 조금씩 다른 것과 비슷하다. 오후 6시 30분에 온 연주자와 6시 50분에 온 연주자가 있다고 해서 공연을 각각 도착 즉시 시작하는 것은 아니다. 모두 오후 7시라는 동일한 시작시간을 기준으로 연주한다. PTP가 ‘오후 7시가 언제인가’를 정의한다면 receiver buffer는 그 시간까지 연주자가 기다리는 대기실에 해당한다.
버퍼는 레이턴시를 만드는 악역이 아니다
디지털 오디오에서는 흔히 버퍼가 작을수록 좋은 것으로 생각한다. DAW에서 ASIO Buffer를 64 samples로 내리면 512 samples보다 모니터링 레이턴시가 줄어드는 것이 대표적인 사례다. 그러나 네트워크 오디오에서 버퍼는 단순히 제거해야 하는 지연이 아니다. “불규칙한 네트워크에서 일정한 오디오 출력을 보장하기 위한 안전장치”다.
수신 레이턴시를 1ms로 설정했다면 패킷은 그 시간 안에 도착해야 한다. 100µs 만에 도착하든 600µs 만에 도착하든 정상적으로 재생할 수 있다. 그러나 패킷이 정해진 재생 시각을 지나 1.1ms 뒤에 도착했다면 상황이 달라진다. 실시간 오디오 시스템은 파일 다운로드처럼 늦게 도착한 패킷을 무한정 기다릴 수 없다. 이미 재생할 시간이 지나갔기 때문이다. Dante Controller에서도 패킷이 설정된 latency에 근접하거나 이를 넘어 도착하면 latency error로 표시하며, 설정값을 넘어선 경우 실제 오디오 glitch가 발생할 수 있다고 명시한다. 따라서 낮은 레이턴시는 항상 좋은 것이 아니다.
네트워크의 최악 조건에서도 패킷이 400µs 안에 들어오는 시스템에서 1ms 버퍼를 사용하는 것은 충분히 안정적이다. 같은 시스템에서 250µs로 줄이면 평상시에는 잘 작동하더라도 순간적인 congestion이 발생했을 때 drop-out 가능성이 커진다. 이것이 네트워크 오디오에서 “‘최저 레이턴시’보다 ‘안정적으로 보장 가능한 레이턴시’가 중요한 이유”다.
라인어레이에서 수십 µs는 정말 문제가 되는가
여기서 프로 오디오 엔지니어에게 익숙한 시간 단위로 돌아갈 필요가 있다. 48kHz 시스템에서 한 샘플의 길이는 약 20.8µs다. 100µs는 약 4.8 samples에 해당한다. 음속을 약 343m/s로 보면 100µs 동안 음파가 이동하는 거리는 약 3.4cm다. 반대로 1ms는 약 34cm에 해당한다. 그래서 라인어레이 또는 여러 스피커가 중첩되는 시스템에서 100µs의 “상대적인” 시간 오차는 무시하기 어렵다. 동일한 신호를 같은 레벨로 재생하는 두 소스 사이에 정확히 100µs의 시간차가 존재한다고 가정하면 첫 번째 완전 상쇄 지점은 약 5kHz에 나타난다. 10kHz에서는 다시 한 주기 차이가 되며 이후에도 comb filtering이 반복된다. 즉 수십~수백 µs는 고역의 합성에서는 충분히 의미 있는 시간이다.
하지만 여기서 한 가지 중요한 구분이 필요하다. “네트워크 전체의 절대 레이턴시가 1ms라는 사실과 두 스피커의 출력이 1ms 어긋나 있다”는 것은 전혀 다른 이야기다. 두 앰프가 각각 1ms의 동일한 네트워크 receiver latency를 사용하고 같은 PTP 시간축에 맞춰 재생한다면 네트워크 패킷의 실제 이동시간이 조금 달라도 두 출력은 정렬될 수 있다.
반대로 네트워크 구간은 정확하게 동기화되어 있더라도 이후의 DSP 경로가 다르면 실제 아날로그 출력은 어긋날 수 있다. 한쪽에는 FIR 필터가 있고 다른 쪽에는 없거나, 서로 다른 제조사의 DSP와 컨버터를 사용하거나, Sample Rate Converter와 look-ahead limiter가 추가되어 있다면 각 장치의 처리시간이 달라진다. 따라서 라인어레이나 Main/Fill, Main/Sub 시스템에서 네트워크 동기화가 정확하다는 이유만으로 실제 음향 출력까지 자동으로 정렬되었다고 판단해서는 안 된다.
네트워크는 “패킷을 공통 시간에 전달하는 문제”를 해결한다. 최종적인 음향 정렬은 여전히 시스템 프로세서와 측정 시스템을 이용해 확인해야 한다. 오히려 여기서 중요한 것은 ‘네트워크가 몇 µs 늦느냐’보다 “서로 다른 신호 경로 사이에 얼마만큼의 상대 지연이 존재하는가”다.
실제 현장에서는 음향 전파시간이 네트워크보다 훨씬 크다
대규모 공연장을 생각하면 이 관계가 더욱 분명해진다. 공기 중에서 소리는 약 1m 이동하는 데 2.9ms 정도가 걸린다. 메인 PA에서 30m 떨어진 딜레이 스피커까지의 음향 전달시간은 약 87ms에 달한다. 이에 비하면 몇 개의 Ethernet 스위치를 통과하며 발생하는 수십~수백 µs의 네트워크 차이는 매우 작다. 그렇다고 네트워크의 시간 정확도가 중요하지 않다는 뜻은 아니다. 오히려 반대다.
스피커 사이의 거리에 따라 발생하는 87ms의 차이는 “알려진 값이며 의도적으로 보정할 수 있는 지연”이다. 반면 네트워크 congestion 때문에 어느 순간 200µs였다가 다음 순간 800µs가 되는 지연은 예측하기 어렵다. 음향 시스템에서는 크기보다 “변동성”이 더 위험한 경우가 많다. 87ms의 고정된 딜레이는 DSP에서 정확하게 보정할 수 있다. 그러나 매 순간 값이 달라지는 지터는 단순한 delay parameter로 해결할 수 없다.
따라서 네트워크 오디오의 목표는 ‘0에 가까운 지연’이 아니라 “경계를 알고 있는 지연, 즉 bounded latency를 확보하는 것”이다.
이 개념은 Milan/AVB 계열에서 특히 명확하게 나타난다. Milan은 gPTP와 Stream Reservation 등의 기능을 이용해 필요한 네트워크 자원과 시간 특성을 관리하고, 예측 가능한 bounded latency를 네트워크 설계의 핵심 요소로 삼는다.
수백 채널 네트워크에서는 채널 수보다 ‘어디로 보내는가’가 중요하다
대규모 네트워크 오디오에서는 자연스럽게 대역폭 문제가 등장한다. 48kHz/24bit PCM 한 채널의 순수 오디오 데이터만 계산하면 약 1.152Mbps다. 여기에 Ethernet과 IP, UDP 등의 헤더가 추가되므로 실제 네트워크 사용량은 더 커진다.
Dante에서는 일반적인 48kHz/24bit 환경을 기준으로 unicast audio flow 하나가 최대 4채널을 포함하며 약 6Mbps의 대역폭을 사용하는 것을 실무적인 계산 기준으로 제시한다. Multicast의 경우 채널당 약 1.5Mbps 정도를 기준으로 계산할 수 있다. 따라서 단순 계산하면 64채널은 약 96Mbps, 256채널은 약 384Mbps, 512채널은 약 768Mbps 수준이다.
이 숫자만 보면 1GbE에서도 상당히 많은 채널을 운반할 수 있는 것처럼 보인다. 그러나 실제 시스템에서는 같은 256채널이 여러 목적지로 이동한다. 예를 들어 대형 콘서트에서 Stage I/O의 입력 신호를 FOH Console, Monitor Console, Broadcast Console과 Recording System이 모두 받아야 한다고 가정해보자. 한 곳으로만 보내는 256채널은 약 384Mbps지만 동일한 데이터를 세 개의 독립적인 목적지로 각각 unicast한다면 공통 구간에서 필요한 트래픽은 조건에 따라 그 배수로 증가할 수 있다. 세 개의 복사본이 하나의 공통 uplink를 통과한다면 단순 합산만으로 약 1.15Gbps가 된다. 이미 1GbE 단일 링크가 감당할 수 있는 범위를 넘어선다.
따라서 네트워크 규모를 평가할 때 ‘몇 채널인가’만 물어서는 부족하다. 보다 중요한 질문은 ‘한 채널을 몇 곳에서 동시에 필요로 하는가’이다. 같은 300채널 시스템이라도 모든 신호가 point-to-point로 이동하는 시스템과 100개의 소스를 각각 20개의 구역에서 사용하는 시스템은 전혀 다른 네트워크다.
Unicast와 Multicast는 ‘1:1’과 ‘공동 배급’의 차이다
Unicast는 하나의 송신자가 하나의 수신자에게 데이터를 보내는 방식이다. FOH 콘솔 한 대만 특정 채널을 필요로 한다면 매우 단순하다. 송신 장치는 FOH를 향해 한 개의 데이터 흐름을 만들면 된다. 그러나 같은 신호를 FOH, Monitor, Broadcast, Recording 네 곳에서 받아야 한다면 동일한 데이터를 네 번 보내야 할 수도 있다.
Multicast는 이를 다르게 처리한다. 송신자는 하나의 multicast stream을 만들고 여러 수신기가 이를 구독한다. 네트워크 스위치가 필요한 지점에서 데이터를 복제하기 때문에 동일한 소스를 다수의 장치에 배포할 때 효율적이다. Audinate 역시 하나의 오디오 채널 또는 채널 그룹을 보통 세 곳 이상에서 받을 경우 multicast가 대역폭을 효율적으로 사용할 수 있는 방법이라고 설명한다.
그러나 multicast가 항상 unicast보다 좋은 것은 아니다. 한 곳에서만 필요한 신호까지 무조건 multicast로 만들면 불필요하게 네트워크 관리가 복잡해질 수 있다. 무엇보다 multicast는 제대로 관리하지 않으면 해당 데이터가 필요하지 않은 포트까지 퍼질 수 있다. 이른바 multicast flooding이다. 바로 여기에서 IGMP가 필요해진다.
IGMP는 거대한 오디오 분배기의 패치 리스트다
IGMP는 Internet Group Manage-ment Protocol의 약자다. 이 이름만 보면 음향 엔지니어가 접근하기 어려운 IT 기술처럼 느껴지지만 역할은 단순하다. 어떤 포트가 어떤 multicast stream을 원하는지 스위치가 기억하도록 하는 것이다.
예를 들어 64채널의 오디오 스트림이 있고 네트워크에는 50개의 장치가 연결되어 있다고 가정하자. 이 중 실제로 해당 스트림을 필요로 하는 장치가 세 대뿐이라면 나머지 47대에는 데이터를 보낼 필요가 없다. IGMP Snooping이 활성화된 스위치는 어떤 수신기가 어떤 multicast group에 가입했는지를 확인해 필요한 포트에만 패킷을 전달한다.
반대로 multicast를 제대로 관리하지 않으면 스위치는 어느 장치가 데이터를 원하는지 판단하지 못해 모든 방향으로 보내버릴 수 있다. RAVENNA의 AES67 네트워크 가이드 역시 unmanaged multicast가 링크와 endpoint를 불필요하게 포화시킬 수 있기 때문에 IGMP를 이용한 관리가 필요하다고 설명한다.
이때 IGMP Snooping과 함께 등장하는 것이 IGMP Querier다. Snooping이 ‘누가 어떤 채널을 듣고 있는지 관찰하는 기능’이라면 Querier는 주기적으로 ‘아직 이 multicast를 받고 싶은 장치가 있는가’를 묻는 역할을 한다. 음향 시스템으로 표현하면 IGMP는 거대한 디지털 분배 시스템의 자동 패치 리스트에 가깝다. Multicast가 많아질수록 이 관리가 중요해진다.
QoS는 대역폭을 늘리지 않는다
네트워크 오디오 이야기를 하다 보면 QoS, Quality of Service라는 용어도 반드시 등장한다. QoS를 네트워크를 빠르게 만드는 기능으로 이해하기 쉽지만 사실 정확한 이해는 아니다. QoS는 도로를 넓히는 기술이 아니라 어떤 차량을 먼저 통과시킬지 결정하는 기술이다. 예컨대 1GbE 링크에 1.2Gbps의 트래픽을 지속적으로 밀어 넣는다면 QoS를 아무리 정교하게 설정해도 1.2Gbps를 모두 전달할 수는 없다. QoS가 의미를 갖는 것은 이처럼 여러 종류의 패킷이 동시에 몰릴 때다.
일반적인 Ethernet 스위치에서 오디오 패킷과 웹 데이터, 파일 전송 패킷은 본질적으로 같은 Ethernet/IP 데이터다. 따라서 스위치에게 어떤 패킷을 먼저 처리해야 하는지 알려줄 필요가 있다. DSCP와 같은 우선순위 표시를 이용하면 패킷을 서로 다른 queue로 분류할 수 있고, 시간에 민감한 데이터부터 먼저 내보낼 수 있다.
네트워크 오디오에서는 특히 PTP가 중요하다. 오디오 패킷 하나가 조금 늦는 것보다 모든 장치의 기준이 되는 시간정보가 흔들리는 것이 시스템 전체에는 더 위험할 수 있기 때문이다. Audinate의 Dante 네트워크 가이드는 mixed-use network에서 PTP와 오디오 트래픽에 QoS를 적용할 것을 권고하며, time-critical PTP traffic을 높은 우선순위로 처리하도록 지정하고 있다. RAVENNA의 AES67 지침 역시 PTP와 미디어 패킷의 jitter를 최소화하기 위해 우선순위 queue를 사용하는 구조를 설명한다.
따라서 음향 엔지니어의 관점에서는 QoS를 이렇게 이해하는 것이 가장 쉽다. [혼잡한 상황에서도 클록과 오디오가 먼저 지나갈 차선을 확보하는 것].
다만 QoS는 설계 불량을 치료하는 만능 기능이 아니다. 기본적인 링크 용량이 부족하다면 uplink를 10GbE로 올리거나 트래픽 경로 자체를 재구성해야 한다.
Traffic이 많아지면 결국 Latency 문제가 된다
대역폭과 레이턴시는 처음에는 서로 다른 문제처럼 보인다. 그러나 네트워크가 커질수록 두 문제는 하나로 연결된다. 링크 사용량이 낮을 때에는 패킷이 스위치에 도착하자마자 거의 그대로 다음 링크로 전달된다. 하지만 같은 egress port로 여러 데이터가 동시에 몰리면 한 번에 하나씩밖에 보낼 수 없으므로 나머지는 queue에서 기다려야 한다. 이것이 queueing delay다.
그리고 네트워크 부하는 항상 정확히 일정하지 않다. 순간적으로 많은 데이터가 몰릴 수도 있기 때문에 queue에서 기다리는 시간도 변화한다. 결과적으로
Traffic 증가 → Queueing 증가 → Jitter 증가 → 더 큰 Receiver Buffer 필요 → Latency 증가
라는 관계가 만들어진다.
따라서 대규모 네트워크 오디오에서 트래픽 관리는 단순히 ‘끊기지 않도록 대역폭을 확보하는 것’ 이상의 의미를 가진다. 트래픽을 관리하는 것은 결국 “시간을 관리하는 일”이다.
VLAN은 네트워크를 나누지만 대역폭을 만들어내지는 않는다
대규모 엔터프라이즈나 복합시설에서는 VLAN도 자주 사용한다. VLAN은 하나의 물리적인 스위치 인프라 안에서 서로 다른 논리적 네트워크를 만드는 방식이다. 오디오 장치와 사내 업무망을 분리하거나 층별, 공연장별, 기능별로 broadcast domain을 분리하는 데 유용하다. 오디오 시스템의 관점에서는 대형 콘솔의 Layer나 DCA처럼 생각하기보다는 “하나의 거대한 물리적 패치 시스템 안에 독립된 여러 패치베이를 만드는 것”에 가깝다.
그러나 VLAN에도 흔한 오해가 있다. VLAN을 나눈다고 실제 케이블의 전송용량이 늘어나는 것은 아니다. 예를 들어 네 개의 VLAN이 하나의 1GbE trunk를 공유하고 있다면 네 VLAN을 합친 전체 데이터는 결국 그 1Gbps 링크를 통과해야 한다. VLAN은 불필요한 broadcast와 multicast의 범위를 줄이고 관리 경계를 만드는 데 효과적이지만 물리적인 uplink capacity 자체를 증가시키지는 않는다.
따라서 수백 채널의 오디오와 영상, 제어 신호가 코어로 집중되는 시스템에서는 edge가 모두 1GbE라고 해서 core까지 1GbE여도 된다는 결론이 나오지 않는다. 여러 개의 1GbE edge traffic이 한 지점으로 모이는 순간 10GbE 이상의 backbone이 필요한 이유가 여기에 있다.
Daisy Chain의 문제는 레이턴시보다 구조에 있다
네트워크 지원 앰프나 스피커, DSP 가운데는 Ethernet 포트가 두 개 있어 다음 장비로 연결할 수 있는 제품이 있다. 이 구조는 설치가 편리하다는 점에서 많은 현장서 사랑받으며, 실제로 많은 장비 제조사들이 이런 기능을 넣어 제품을 설계 및 출시하고 있다. 첫 번째 장비에서 두 번째, 두 번째에서 세 번째 장비로 이어가면 별도의 스위치를 여러 곳에 설치하지 않아도 된다.
그러나 Daisy Chain을 길게 만들수록 고려할 요소가 늘어난다. 각 endpoint 내부의 네트워크 switch를 추가로 통과하므로 hop이 늘어난다. 중간 장비가 재부팅되거나 전원을 잃었을 때 뒤쪽 연결까지 영향을 받을 수 있는 제품도 있다. 장애 지점을 찾기도 어려워지고, 하나의 링크가 뒤쪽 여러 장치의 traffic을 동시에 부담할 수도 있다.
그렇다고 Daisy Chain을 사용하면 곧바로 라인어레이 정렬이 틀어진다고 볼 수는 없다. 앞서 설명했듯 정상적으로 동기화된 네트워크에서는 각 수신기가 공통 시간축에 맞춰 재생하기 때문이다. 오히려 대형 시스템에서 Daisy Chain을 제한하는 가장 현실적인 이유는 “레이턴시의 단순 누적보다 장애 범위와 트래픽 집중, 토폴로지의 예측 가능성”에 있다. 규모가 커질수록 Access–Distribution–Core처럼 계층화된 구조를 사용하는 이유도 같다. 모든 장비의 경로와 bottleneck을 설계자가 파악하기 쉬워진다.
PTP-aware Switch가 항상 필요한 것은 아니다
PTP 이야기가 나오면 반드시 PTP를 지원하는 고가의 스위치를 사용해야 한다고 생각하기 쉽다. 이 역시 프로토콜과 시스템 규모에 따라 다르다. 일반적인 Dante 네트워크에서 Audinate는 PTP-aware switch를 필수 조건으로 두지 않으며 대부분의 경우 스위치에서 Boundary Clock이나 Transparent Clock 기능을 켤 필요가 없다고 설명한다.
반면 AES67/RAVENNA처럼 PTPv2를 사용하는 대규모 시스템에서는 상황이 달라질 수 있다. 스위치를 매우 많이 통과하거나 네트워크 부하가 높아지면 PTP 메시지 자체가 받는 지터가 증가할 수 있다. 이런 환경에서는 Transparent Clock이 스위치 내부에서 소비된 시간을 보정하거나 Boundary Clock이 PTP 영역을 구분해 각 구간에 보다 안정적인 시간을 제공하는 방식이 유용할 수 있다. RAVENNA 역시 대규모 또는 높은 부하가 걸리는 AES67 환경에서는 Boundary Clock이나 Transparent Clock과 같은 PTP-aware switch를 고려하도록 안내한다. 따라서 ‘PTP 스위치가 좋다’ 또는 ‘필요 없다’는 식의 단순한 결론보다는 “사용하는 AoIP 규격과 네트워크 규모에 따라 요구사항이 달라진다”고 이해해야 한다.
Dante 자체 오디오에서는 기본적으로 PTPv1이 사용되고 AES67 및 ST 2110-30 운용에는 PTPv2가 등장한다. 혼합 네트워크에서는 이 차이까지 고려해야 한다. 최신 Dante 장치에서도 AES67/ST 2110-30을 위한 PTPv2 설정을 별도로 제공한다.
콘서트와 멀티트랙 레코딩을 동시에 한다면
실제 현장에서 흥미로운 사례 중 하나는 대형 콘서트와 멀티트랙 레코딩을 하나의 네트워크에서 처리하는 경우다. 가령 Stage Rack에서 128개의 입력이 발생한다고 가정하자. 이 신호가 FOH Console과 Monitor Console으로 전달되고, 동시에 128채널 DAW에 녹음되며 일부 신호는 Broadcast Console과 시스템 프로세서에서도 사용된다. 이때 모든 목적지가 같은 latency를 가져야 할 이유는 없다.
FOH와 Monitor 등 실제 PA 경로는 가능한 짧고 안정적인 latency가 중요하다. 특히 연주자의 IEM 경로에서는 몇 ms의 차이도 체감될 수 있다. 반면 Recording DAW는 약간 더 긴 network buffer를 사용해도 문제가 없다. 녹음 파일이 공연장의 스피커를 실시간으로 구동하는 것이 아니라면 안정성이 낮은 latency보다 우선한다.
실제로 Dante Virtual Soundcard의 latency 설정은 네트워크의 하드웨어 Dante 장치와 독립적으로 사용할 수 있다. 예를 들어 하드웨어 PA 경로가 1ms로 동작하는 동안 DVS는 더 높은 값을 사용해 레코딩 안정성을 확보할 수 있다. Audinate 역시 고성능 컴퓨터에서는 4ms를 출발점으로 사용하고 시스템 상황에 따라 6ms나 10ms와 같이 더 큰 값을 사용할 수 있다고 안내한다.
이것은 매우 중요한 설계 원칙이다. [네트워크 전체를 하나의 latency 값으로 맞춰야 하는 것이 아니다]. 실시간 PA 경로와 레코딩 경로의 요구조건은 다르다. 각각의 목적에 적절한 latency budget을 설정하는 것이 더 합리적이다.
포스트프로덕션에서는 컴퓨터가 가장 느린 endpoint가 될 수도 있다
포스트프로덕션 스튜디오에서도 비슷한 문제가 발생한다. 수백 채널의 오디오를 여러 편집실과 dubbing stage, machine room 사이에서 공유할 수 있다는 것은 네트워크 오디오의 매우 큰 장점이다. 하지만 전용 하드웨어 DSP와 일반 컴퓨터는 시간 특성이 다르다.
전용 네트워크 오디오 하드웨어는 Ethernet packet 처리와 clock synchronization을 위해 설계된 반면 PC와 Mac은 오디오만 처리하는 장비가 아니다. 운영체제와 드라이버, CPU scheduling, DAW buffer, 플러그인이 모두 추가적인 변수가 된다. 따라서 네트워크 자체가 1ms 이하로 동작한다고 해서 DAW 입출력까지 1ms가 되는 것은 아니다.
특히 Native Plugin, Look-ahead Processing, Linear Phase EQ, FIR Convolution 등을 사용하면 네트워크보다 플러그인 처리시간이 훨씬 큰 경우도 흔하다. 이 때문에 대형 포스트 시스템에서는 ‘네트워크가 느리다’고 판단하기 전에 latency가 실제로 어느 구간에서 발생하는지 나누어 측정해야 한다. Network Latency와 Computer Audio Buffer, Plugin Delay Compensation을 하나의 숫자로 섞어버리면 문제를 찾기 어려워진다.
스타디움과 쇼핑몰에서는 낮은 레이턴시보다 안정성이 더 중요하다
스타디움이나 쇼핑컴플렉스, 공항, 캠퍼스와 같은 대규모 분산 음향 시스템은 공연장과 요구조건이 다르다. 하나의 소스를 수십 또는 수백 개의 구역으로 보내는 일이 많기 때문에 multicast의 효율성이 크게 드러난다. 반대로 multicast 관리가 잘못되면 매우 많은 트래픽이 필요하지 않은 구역까지 퍼질 수 있으므로 IGMP 설계의 중요성도 커진다.
먼저 생각할 것은 이들 시스템에서는 250µs와 1ms의 차이가 사용자 경험에 큰 영향을 주지 않는 경우가 많다. 대신 장시간 끊김 없이 동작해야 하고 네트워크 일부에 장애가 발생하더라도 전체 방송 시스템이 멈추어서는 안 된다. 긴 광케이블 구간과 여러 건물, 여러 VLAN을 통과하더라도 clock synchronization과 traffic path가 예측 가능해야 한다. 즉 대규모 Installed Sound에서 네트워크의 목표는 Ultra-Low Latency보다는 [Deterministic, Scalable, Redundant]이 우선한다.
네트워크의 상태는 귀보다 먼저 숫자로 확인해야 한다
아날로그 시스템의 이상은 대개 귀로 먼저 발견할 수 있었다. 험이 들리거나 레벨이 떨어지고 왜곡이 발생한다. 네트워크는 다르다. 평상시에는 아무 문제가 없다가 특정 시간에만 glitch가 발생할 수 있다. 네트워크 사용량이 순간적으로 증가하거나 PTP 상태가 흔들리거나 특정 uplink에서 latency가 receiver buffer의 경계에 접근할 수 있기 때문이다. 따라서 대규모 AoIP 시스템에서는 단순히 ‘소리가 정상적으로 나온다’는 것만으로 상태를 판단해서는 안 된다.
Transmit/Receive Bandwidth, Packet Error, Clock Status, Latency Histogram과 같은 정보를 지속적으로 확인해야 한다. Dante Controller 역시 장치별 transmit/receive bandwidth, latency statistics, clock stability와 packet error 등을 확인할 수 있도록 제공한다. 특히 정상적인 시스템의 값을 미리 기록해두는 것이 중요하다.
평소 특정 endpoint의 packet latency가 180~220µs 범위인데 어느 날 700µs까지 증가했다면 아직 음이 끊기지 않았더라도 네트워크 어딘가에 변화가 생겼다는 의미다. 프로 오디오에서 헤드룸을 0dBFS에 닿기 전에 관리하듯 네트워크에서도 dropout이 발생하기 전에 “latency와 bandwidth의 headroom을 관리해야 한다.”
결국 관리해야 할 것은 ‘시간의 불확실성’
네트워크 오디오를 처음 접하면 레이턴시를 하나의 숫자로 생각하기 쉽다. 0.25ms가 1ms보다 좋고 1ms가 5ms보다 좋다고 생각한다. 하지만 실제 대규모 시스템에서는 반드시 그렇지 않다.
항상 2ms의 지연을 가지는 시스템과 평상시에는 0.2ms지만 상황에 따라 0.2~3ms 사이에서 변하는 시스템이 있다면 프로 오디오에서는 전자가 더 유용할 수 있다. 2ms라는 값을 알고 있다면 DSP에서 보상할 수 있기 때문이다. 반면 매 순간 달라지는 값은 정확하게 보상할 수 없다.
따라서 네트워크 오디오에서 관리해야 할 진짜 대상은 레이턴시 자체가 아니라 “레이턴시의 불확실성”이다. 이를 위해 PTP로 공통 시간축을 만들고, receiver buffer로 network jitter를 흡수하며, QoS로 시간에 민감한 패킷을 우선 처리한다. Multicast가 필요하다면 IGMP로 이동 범위를 제어하고, VLAN으로 트래픽 영역을 나누며, 충분한 backbone bandwidth를 확보한다. 그리고 이 모든 장치는 결국 하나의 목적을 가진다. “오디오 샘플을 정확한 시간까지 목적지에 가져다 놓는 것.”
네트워크 오디오는 결국 ‘시간을 전송하는 기술’
네트워크 오디오가 전통적인 오디오 배선과 가장 크게 다른 지점은 여기에 있다. 아날로그 시스템에서는 케이블을 따라 신호가 흐른다. 네트워크에서는 패킷이 이동한다. 그러나 프로 오디오에서 필요한 것은 단순한 데이터가 아니다. 왼쪽 라인어레이와 오른쪽 라인어레이, 메인 PA와 프런트필, 무대의 I/O와 FOH 콘솔, 방송실과 레코딩 시스템이 모두 ‘이 샘플이 언제 재생되어야 하는가’를 공유해야 한다.
따라서 대규모 네트워크 오디오를 설계할 때 가장 먼저 물어야 할 질문은 ‘몇 채널까지 들어가는가’가 아니다. 어떤 신호가 어디로 이동하는가, 몇 개의 장치가 같은 신호를 필요로 하는가, 가장 혼잡한 링크는 어디인가, 어떤 경로에 가장 낮은 레이턴시가 필요한가, 어떤 경로는 안정성을 위해 더 큰 버퍼를 허용할 수 있는가, 클록은 어떤 경로를 지나며 장애가 발생했을 때 무엇이 기준이 되는가가 가장 중요하다. 이 질문에 답할 수 있어야 네트워크의 규모가 커져도 시스템의 시간축을 통제할 수 있다.
스위치를 하나 더 거치면 몇 µs가 증가하는지를 아는 것도 필요하다. 그러나 그것만으로 대규모 AoIP 시스템을 이해할 수는 없다. 네트워크 오디오에서 가장 중요한 것은 가장 낮은 레이턴시가 아니다. 오히려 “필요한 모든 신호가, 필요한 모든 장소에서, 약속된 시간에 재생된다는 사실을 보장하는 것”이다. 결국 프로 오디오 네트워크 설계란 수백 개의 오디오 채널을 Ethernet 케이블에 집어넣는 기술이 아니다. “수백 개의 오디오 채널이 공유하는 하나의 시간을 설계하는 기술이다.